

முக்கிய விஷயங்கள்
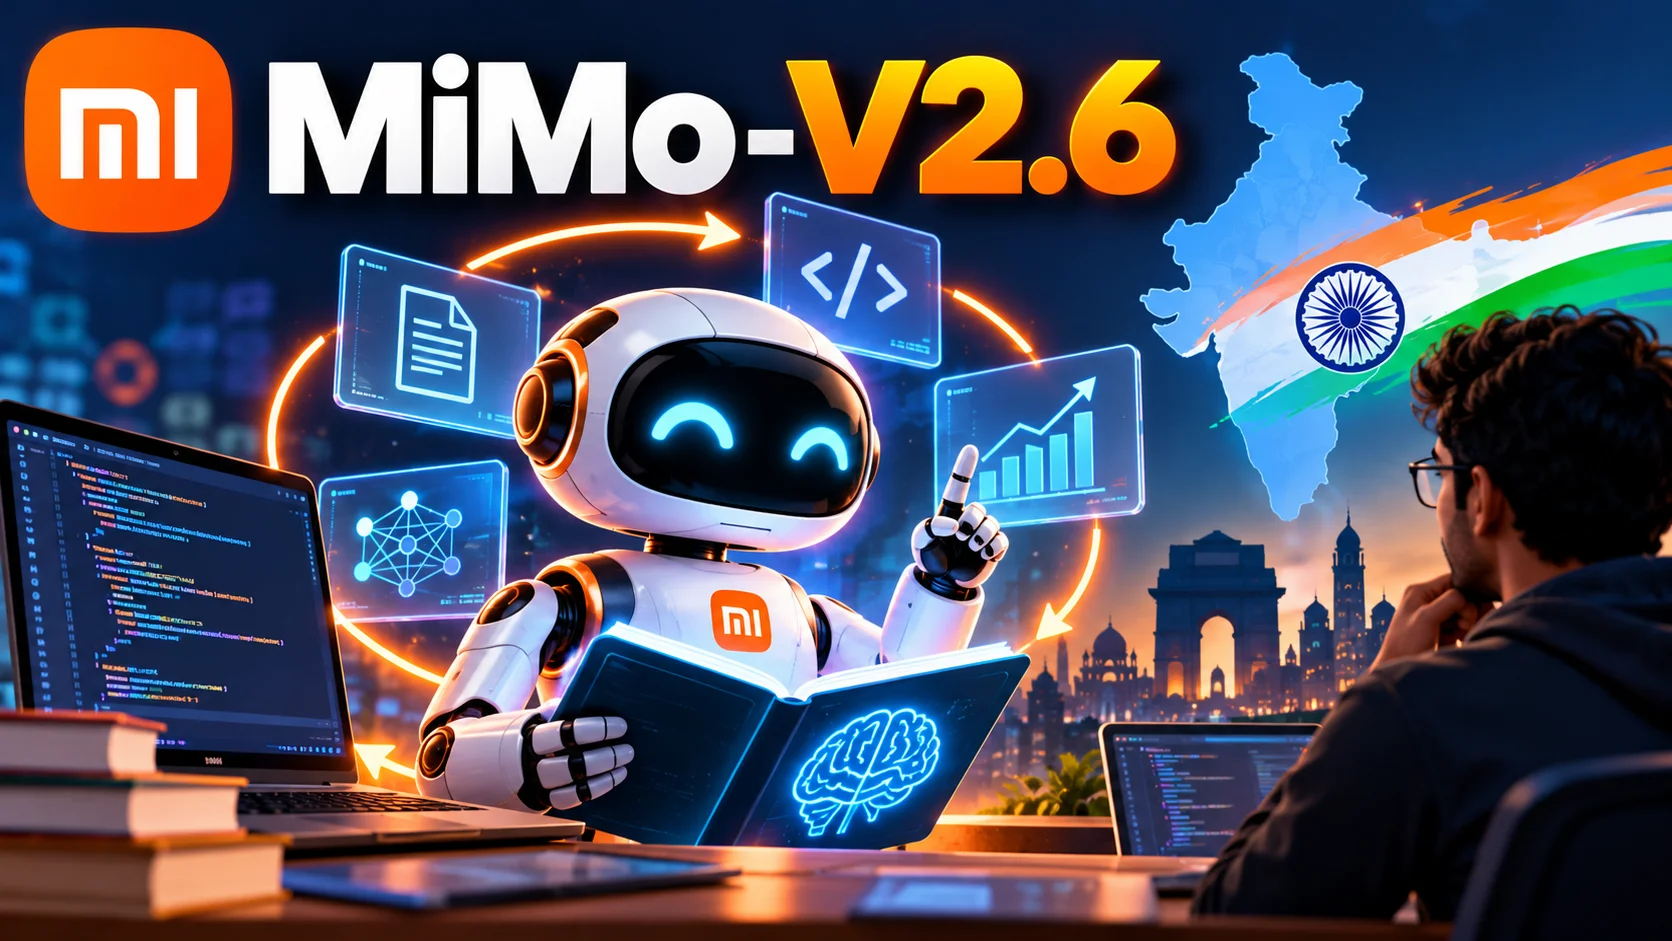
- Xiaomi-ன் MiMo Team, MiMo-V2.6 என்ற Research Paper-ஐ வெளியிட்டு, AI Model தானாக தன்னை மேம்படுத்திக்கொள்ள Reinforcement Learning (RL) Compute-ஐ பெரிய அளவுல Scale பண்ணியிருக்காங்க.
- Code, Visual, General, Cyber Task-கள்ல, ஒரு Training Step-க்கு 3.7 பில்லியன் Token வரைக்கும் கையாளும் அளவுக்கு இந்த Model-ஐ Train பண்ணியிருக்காங்க.
- Model-க்கு நீளமான, பல Step-கள் உள்ள Task-களில் சரியான Feedback கொடுக்க, ஒரு Stronger Grading System-ஐ உருவாக்கியிருக்காங்க — இது Model-ஐ Short, Efficient Answer கொடுக்க வைக்குது.
- Training Process, RL Environments, Framework எல்லாத்தையும் Xiaomi Open-Source பண்ணியிருக்காங்க — இது இந்திய Researchers, Startups-க்கு ரொம்ப உபயோகமா இருக்கும்.
- இது இன்னும் Research மட்டும்தான், Product இல்ல. MIUI, HyperOS அல்லது எந்த Consumer App-க்கும் இந்த Paper-க்கும் தொடர்பு இல்ல.
என்ன நடந்தது?
Hugging Face-ல Daily ஒரு புது AI Paper Trend ஆகும். சமீபத்தில் அந்த Spot-ஐ பிடிச்சிருக்கு Xiaomi-ன் MiMo Team Research. Paper Title: MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement. 60 Upvotes வாங்கியிருக்கு Hugging Face-ல. ஒரு Dense Technical Paper-க்கு இது நல்ல Number-தான், AI Community இதை Seriousஆ படிக்குறாங்கன்னு அர்த்தம்.
இந்த Paper-ல Researchers சொல்றது என்னன்னா, Reinforcement Learning (RL) தான் இப்போ Big AI Model-களை Self-Improvement நோக்கி கொண்டு போகுற Main Training Method. அதாவது, Companies இப்போ Model-க்கு வெறும் Internet Text-ஐ Feed பண்ணிட்டு இருக்கல. அதுக்கு பதிலா, ஒரு Practice Ground உருவாக்கி, Model அதில் முயற்சி செய்யும், Score கிடைக்கும், அப்புறம் தன்னை Fix பண்ணிக்கும் — இது Repeat ஆகும், அதுவும் மிகப்பெரிய Scale-ல.
MiMo-V2.6-ஐ ஒரு 'Omni-Modal' Family-ன்னு சொல்றாங்க. அதாவது, இது Text, Image, Code — எல்லாத்தையும் ஒரே Roof-க்கு கீழ Handle பண்ணும் வகையில் Design பண்ணப்பட்டிருக்கு. இதுக்கு Base-ஆ 'Hybrid-SWA Architecture' பயன்படுத்தியிருக்காங்க.
RL Training Start ஆவதுக்கு முன்னாடியே, Team ஒரு 'Mid-Training' Step பண்ணிருக்காங்க — ஒரு Wide Multimodal Dataset-ல Model-க்கு Exploration Space கொடுத்து, அதன்பிறகுதான் Serious Drilling Start ஆகுது.
இது எப்படி வேலை செய்யும்? (அதாவது + உதாரணம்)
இத ஒரு Cricket Coaching மாதிரி நினைச்சு பாருங்க. ஒரு 16 வயசு Boy-ஐ எடுத்து 'நீ India Team-க்கு Play செய்' அப்படி சொல்ல மாட்டாங்க இல்லையா.
அவனுக்கு Net Practice, Fitness, Match Simulation — எல்லாம் Step-By-Step கொடுப்பாங்க. ஒவ்வொரு Session முடிஞ்சவுடனே, Coach Footage-ஐ Review பண்ணி 'இது Fix பண்ணு, அது Fix பண்ணு' அப்படி சொல்லுவாரு.
MiMo-V2.6-ல நடந்தது இதே Logic தான். ஆனா இங்க 'Player' AI Model, 'Coach' ஒரு Reward System. இந்த Coaching Process-ஐ Paper-ல மூணு Direction-ல Scale பண்ணியிருக்காங்க.
முதல் Direction — Bigger Practice Sessions. Training Setup ஒரு Step-க்கு 1,568 Samples, 2.7 முதல் 3.7 பில்லியன் Token வரைக்கும் Process செய்யுது. Context Length 1 மில்லியன் Token வரைக்கும் போகுது — அதாவது, Model ஒரே Time-ல அதிக அளவு Information-ஐ தன் 'Working Memory'-ல வெச்சுக்கிட்டே Learn பண்ணுது.
இரண்டாவது Direction — Tougher, More Varied Drills. வெறும் Coding Problem மட்டும் இல்லாம, Code, General Reasoning, Visual, Cyber-Security Task-கள் வரைக்கும் Model-ஐ Push பண்ணியிருக்காங்க. அதாவது, ஒரு Student-ஐ வெறும் Maths Exam-க்கு மட்டும் Prepare பண்ணாம, Science, Language, Logic Test எல்லாத்துக்கும் ஒரே நேரத்துல Ready பண்றது மாதிரி.
மூணாவது Direction — More Grader Compute. இதுதான் Interesting Part. Model செய்யுற Task-ஐ 'Groupwise Agentic Grading' மூலமா Check பண்றாங்க — அதாவது, ஒரு Answer-ஐ தனியா Check பண்றதுக்கு பதிலா, Group ஆ வெச்சு Compare பண்ணி Score கொடுக்குறாங்க. இது Long-Horizon Task-களுக்கு (நீளமான, பல Step உள்ள Task) Accurate Reward Signal கொடுக்குது. Result-ஆ Model Short, Token-Efficient Answer கொடுக்க கத்துக்குது — Unnecessary-ஆ Long-ஆ யோசிக்காம, நேரா Point-க்கு Answer சொல்ற Habit வரும்.
Training Stable-ஆ வெச்சுக்க, MoE Router-ஐ Freeze பண்ணியிருக்காங்க, Reward Hacking-க்கு எதிரா Multi-Layer Defense Build பண்ணியிருக்காங்க. Reward Hacking என்றால், Model Actual Task Solve பண்ணாம, Reward System-ஐ 'Trick' பண்ணி Score மட்டும் வாங்குற Problem — இது RL Training-ல பெரிய Headache.
இந்தியாவுல / நம்ம Phone-ல என்ன மாறும்?
முதல்ல Clear-ஆ சொல்லிடுறோம் — இது இன்னும் Research Paper மட்டும்தான். MIUI, HyperOS அல்லது எந்த Xiaomi Consumer App-ல இந்த Model வருமா-வராதான்னு இந்த Paper-ல எந்த Announcement-ம் இல்ல.
ஆனா, இந்த Research இந்திய AI Community-க்கு ஏன் முக்கியம்னா, Xiaomi இந்த Training Process, RL Environments, RL Framework-ஐ Open-Source பண்ணியிருக்காங்க. அதாவது, எந்த ஒரு Indian Researcher, PhD Student, அல்லது Startup Team-மும் இந்த Framework-ஐ எடுத்து தங்க Model-ல Try பண்ணலாம்.
Bengaluru, Hyderabad, Chennai-ல இருக்குற AI Startups, Enterprise RL Technique-ஐ Study பண்ணி, தங்க Chatbot, Coding Assistant, Customer Support Agent-களை Improve பண்ண இந்த Research ஒரு Reference Point ஆகலாம்.
Indian Engineering Colleges-ல AI/ML படிக்குற Students-க்கு, Reinforcement Learning-ல Real-World Scale Example படிக்க நல்ல Case Study இது. Interview-ல 'RL Scaling Challenges' பத்தி Question வந்தா, இந்த Paper-ல இருக்குற Reward Hacking Defense, Router Freezing மாதிரி Concept-களை Reference-ஆ எடுத்துக்கலாம்.
Developer Jobs Angle-ல பார்த்தா, Agentic AI, RL Fine-Tuning, Reward Modeling மாதிரி Skills-க்கு Demand இப்போ India IT Market-ல அதிகரிச்சிட்டே இருக்கு. இந்த மாதிரி Open-Source Research, அந்த Skill Gap-ஐ Fill பண்ண உதவும்.
இதை ஒரு 'India-Specific' News-ஆ யோசிக்காதீங்க. இது Global AI Research Trend-ஐ காட்டுது — Pretraining-க்கு அப்புறம் இப்போ எல்லா Big Players-மும் RL Scaling-ல கவனம் வெச்சிருக்காங்க. Xiaomi, OpenAI, Google, Anthropic — எல்லாரும் இதே Direction-ல போயிட்டு இருக்காங்க.
நீங்க இப்போ என்ன பண்ணுங்க?
நீங்க ஒரு ML Student அல்லது Researcher-ஆ இருந்தா, Hugging Face Paper Page-ல போய் இந்த Open-Source Training Dynamics, RL Environments-ஐ பாருங்க. Practical-ஆ RL Scale பண்றது எப்படினு Theory மட்டும் படிக்காம, Code Level-ல Study பண்ண வாய்ப்பு கிடைக்கும்.
நீங்க ஒரு Normal Tech Reader-ஆ இருந்தா, இந்த Paper-ஐ ஒரு 'Xiaomi Phone Feature Update'-ஆ எதிர்பார்க்காதீங்க. இது Background Research. இதுல இருந்து வரப்போற Techniques, 1-2 வருஷத்துல Consumer Products-ல மெதுவா Appear ஆகும் — அதுவரைக்கும் Patience வெச்சுக்கோங்க.
Startup Founders, CTOs இருந்தா, இந்த Paper-ல சொல்லியிருக்குற 'Groupwise Agentic Grading' Idea-ஐ உங்க Internal Eval System Design பண்றப்போ Reference எடுத்துக்கலாம். Long-Task Agent Build பண்ணுறவங்களுக்கு இது Directly Relevant.
இதுல Common-ஆ நடக்குற Mistake-ஸ் என்ன?
இந்த Paper வந்தவுடனே பல பேருக்கு ஒரு Confusion வருது — 'அடுத்த Xiaomi Phone-ல இந்த AI வருமா?' அப்படினு. இது Research Paper, Product Launch இல்ல. Madurai-ல ஒரு Tuition Master புதுசா ஒரு Teaching Method Develop பண்ணி, அதை Conference-ல Paper-ஆ Publish பண்றது மாதிரி நினைச்சுக்கோங்க. அந்த Method நல்லதா இருந்தாலும், அது உடனே எல்லா School Classroom-லயும் வந்து சேராது. அதே Logic தான் இங்கயும் — MiMo-V2.6 Technique நல்லதா இருந்தாலும், அது HyperOS Update-ல நாளைக்கே வந்துடும் அப்படி எதிர்பார்க்கிறது தப்பு.
இரண்டாவது Mistake, 'Open-Source Framework' என்றால் 'Ready-Made App' அப்படி நினைக்கிறது. Chennai-ல ஒரு Startup இந்த RL Framework-ஐ Download பண்ணினாலும், அதை Run பண்ண High-End GPU Server, நிறைய Compute Budget தேவைப்படும். IRCTC Tatkal Booking-க்கு Fast Internet இருந்தா மட்டும் Ticket கிடைக்காது, Server Load, Timing எல்லாம் Matter செய்யும் இல்லையா — அதே மாதிரி, Framework Free-ஆ இருந்தாலும், அதை Practical-ஆ பயன்படுத்த Infrastructure Cost ஒரு பெரிய Factor.
மூணாவது Mistake — 60 Hugging Face Upvotes-ஐ வெச்சு 'இது Already Proven, Market-Ready Tech' அப்படி முடிவு பண்றது. Research Community-ல Upvotes என்றது Interest-ஐ காட்டும், ஆனா Real-World Deployment Guarantee இல்ல. Reward Hacking Defense, MoE Router Freezing மாதிரி Technique-கள் இன்னும் Active Research Phase-ல இருக்கு — இதை ஒரு College Student தன் Final Year Project-க்கு Reference எடுத்தாலும், இன்னும் நிறைய Testing, Fine-Tuning தேவைப்படும்னு Honest-ஆ புரிஞ்சுக்கணும்.

கருத்துகள் (0)
Be the first to comment!