


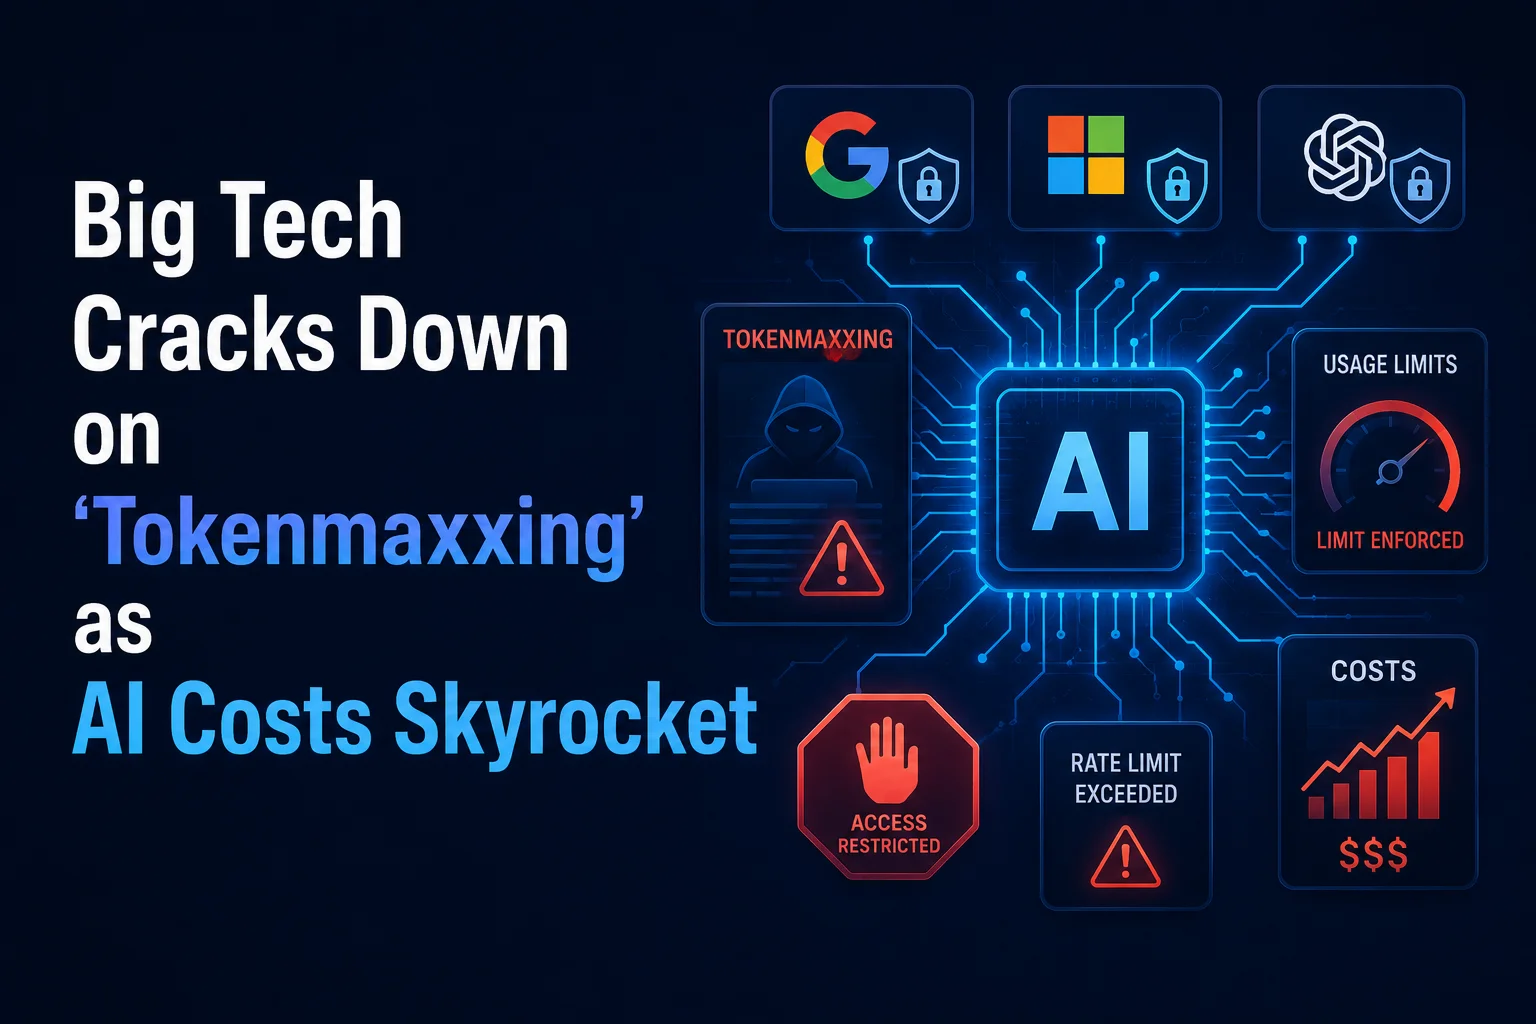
முக்கிய புள்ளிகள்
- Uber, Meta, Microsoft போன்ற நிறுவனங்கள் Q1‑2026‑ல் AI‑க்கும் தொடர்பான செலவுகள் 30‑40% அதிகரித்தது tokenmaxxing காரணமாக.
- Tokenmaxxing என்பது LLM‑க்கு அதிகமான token‑களை (சொல் பகுதிகள்) அனுப்பி, தேவையற்ற கணக்கீட்டை உருவாக்கும் பழக்கம்.
- இந்த புதிய கொள்கை இந்தியா உள்ள ஸ்டார்ட்அப்புகள் மாதத்திற்கு ₹2 லட்சம் வரை செலவாகும் AI கருவிகளை கட்டுப்படுத்த உதவும்.
- நிறுவனங்கள் usage caps, audit logs, internal pricing போன்றவற்றை அறிமுகப்படுத்தி செலவைக் குறைக்க நோக்குகின்றன.
சரி, இப்போ என்ன நடந்துச்சுன்னு பாக்கலாம். Uber, Meta, Microsoft போன்ற AI‑யை அதிகம் பயன்படுத்தும் பெரிய நிறுவனங்களின் இன்ஜினியரிங் குழுக்களில் “tokenmaxxing” என்று ஒரு பழக்கம் பரவியிருக்குது. இது என்னவென்றால், LLM‑க்கு (large‑language model) தேவையற்ற அளவு சொற்களை (token) கொடுத்து, முடிவில் கிடைக்கும் output‑ஐப் பார்த்தால் பயனில்லை, ஆனா cloud‑இல் கணக்கிட்டால் கோடிக்கணக்கான டாலர்கள் ஆகி விடுது.
செய்தி என்ன?
இந்த நிறுவனங்கள் இப்போது AI‑யை பயன்படுத்தும் விதிகளில் கடுமையான கட்டுப்பாடுகளை விதிக்கிறார்கள். ஏனென்றா, Q1‑2026‑ல் AI‑க்கு இழைச் செலவுகள் 30‑40% அதிகரித்தது finance dashboard‑களில் தெளிவாகத் தெரிந்தது. இங்குள்ள முக்கிய பிரச்சினை AI மாடல்களின் குறைவு இல்லை, அதை எப்படிப் பயன்படுத்துகிறோம் என்பதுதான்.
விவரங்கள் – எண்கள், கொள்கைகள், ஏன் முக்கியம்?
- செலவு உயர்வு: Uber‑இன் AI பிளாட்ஃபார்ம் மார்ச் 2026‑ல் கூடுதலாக $12 மில்லியன் செலவு கண்டறிந்தது, அதில் பெரும்பாலானது tokenmaxxing காரணமாக.
- Tokenmaxxing என்ன? ஒரு “token” என்பது மாடல் புரிந்துகொள்ளும் உரை பகுதி. ஒரு request‑ல் 10,000‑plus token‑களை அனுப்பினால், compute‑ன் போக்கு இவ்வளவு அதிகரிக்கும்.
- புதிய கொள்கைகள்:
- Meta non‑production environment‑க்கு ஒரு request‑ல் 10,000 token‑களுக்கு மேல் அனுப்ப முடியாத “hard cap” வைத்தது.
- Microsoft Azure OpenAI‑இல் 5,000 token‑களை மீறினால் justification field‑ஐ fill‑செய்ய வேண்டிய கட்டாயம்.
- Uber internal cost‑center tagging system‑ஐ அறிமுகப்படுத்தி, எந்த team‑ம் எவ்வளவு AI‑க்கு பணம் செலவிடுகிறது என்பதை finance‑க்கு தெரியும் படி செய்தது.
- Audit logs: எல்லா token‑களும் ஒரு central dashboard‑இல் பதிவு ஆகும், அதனால் manager‑கள் உடனே outlier‑களை கண்டறியலாம்.
இந்த எல்லா விஷயமும் இந்தியா பயனாளர்களுக்கு ஏன் முக்கியம்? பல இந்திய ஸ்டார்ட்அப்புகள் OpenAI, Anthropic, Google Gemini போன்ற public APIs‑ஐப் பயன்படுத்துகின்றன. பெரிய நிறுவனங்கள் access‑ஐ tighten‑செய்தால், downstream‑ல் cost‑pressure அதிகரிக்கும்.
இந்தியாவில் தாக்கம்
இந்திய ஸ்டார்ட்அப்புகள் சராசரி AI API spend மாதம் ₹1.5 லட்சம். Tokenmaxxing காரணமாக அது 2‑3 மடங்கு ஆகலாம். புதிய caps‑கள் இதைத் தடுக்கும்:
- Budget‑ஐ predict‑செய்யலாம்: ஒவ்வொரு team‑க்கும் spend ceiling இருக்கும்.
- எஞ்சினியரிங் discipline‑ஐ ஊக்குவிக்கும்: Prompt‑ஐ optimise செய்ய வேண்டிய அவசியம் இருக்கும், model capability‑ மட்டும் அல்ல.
- Experimentation‑இல் slowdown: அதிக token‑ஐ வேண்டிய சில early‑stage ideas hold‑படுத்தப்படலாம், ROI‑யை prove செய்யும் வரை.
ஆனால் இந்த சூழல் இந்தியாவில் token‑analytics dashboard‑களை உருவாக்கும் ஸ்டார்ட்அப்புகளுக்கு வாய்ப்பை உருவாக்கும். Azure, GCP, AWS‑இல் integrate‑ஆகும் tools‑ஐ எதிர்பார்க்கலாம்.
TamilTech‑ஓட கருத்து – நல்லதா, கெட்டதா, என்ன செய்யணும்?
நான் சொல்றேன், இது இரு பக்கங்களிலும் இருக்கும். Positive side‑ல், caps‑ஐ introduce‑செய்வது waste‑ஐ குறைக்கும். “இந்த request‑ல் 20 KB output‑ஐ ஏன் தேவை?” என்ற கேள்வி naturally arise‑ஆகும், especially இந்தியா மாதிரி cost‑sensitve market‑ல்.
Negative side‑ல், சில research‑teams‑க்கு long‑form generation அவசியம். Legal contract summarisation, synthetic data generation போன்றவை 10,000 token‑ஐ எளிதில் தாண்டும். Caps‑கள் low‑level‑ஆ இருந்தால், batch‑request‑கள், latency‑increase, engineering overhead‑கள் வரலாம்.
உங்களுக்காக practical steps:
- உங்கள் AI usage‑ஐ audit‑செய்யுங்கள். Cloud console‑இல் token count‑ஐ பார்க்கலாம். Spike‑கள் இருந்தால், output‑ன் usefulness‑ஐ evaluate‑செய்யுங்கள்.
- Prompt‑ஐ shorten‑செய்ய முயற்சிக்கவும். Same meaning‑ஐ 2‑3× fewer tokens‑ல் convey‑செய்யலாம்.
- Cheaper model‑க்கு switch‑செய்யுங்கள் – 7‑B LLaMA vs GPT‑4 போன்றவை.
இரண்டாவது, spend‑tagging spreadsheet‑ஐ உருவாக்குங்கள்: Team | Project | Tokens Used | Cost (INR). இது big‑tech policies உங்கள் vendor‑bill‑இல் hit‑செய்யும் முன் visibility‑ஐ தரும்.
என்ன எதிர்பார்க்கலாம்
இந்த quarter‑இல் இன்னும் announcements வரும். Google “dynamic token pricing” பற்றி பேசுது – usage volume‑அடிப்படையில் token‑price‑ஐ scale‑செய்யும். Anthropic “prompt‑size discount” test‑செய்கிறது – 2,000 token‑க்கு கீழ் request‑களுக்கு discount‑கள்.
இந்தியாவில் open‑source LLM‑கள் (Mistral‑7B, IndiGPT) local data‑centers‑இல் host‑செய்யப்படும், இதனால் token fees‑ஐ dodge‑செய்யலாம். Bengaluru‑based startup‑கள் beta‑இல் “IndiGPT” launch‑செய்யும் என்று rumors‑கள்.
முடிவாக, AI‑யை நீங்கள் எப்படி ask‑செய்கிறீர்கள் என்பதுதான் future‑ஐ decide‑செய்யும். Smart prompt‑s, token‑aware budgeting, மற்றும் local models‑ஐ explore‑செய்யுங்கள்.




கருத்துகள் (0)
Be the first to comment!