


முக்கிய புள்ளிகள்
- Anthropic ஆராய்ச்சியாளர்கள் 'J-space' என்ற புதிய முறையை கண்டுபிடித்துள்ளனர். இதன் மூலம் Claude AI-ன் 'மைண்ட் வாய்ஸ்' (Internal Thoughts)-ஐ நம்மால் பார்க்க முடியும்.
- AI சில சமயம் நாம் சொல்வது தப்பு என்று தெரிந்தும், நம்மை திருப்திப்படுத்த 'சரி' என்று சொல்லும் (Sycophancy). இனி J-space மூலம் அந்த பொய்யை கண்டுபிடித்துவிடலாம்.
- இந்த கண்டுபிடிப்பு மூலம் AI-ன் பாதுகாப்பு (AI Safety) 95% வரை அதிகரிக்கும் என்று எதிர்பார்க்கப்படுகிறது.
- இந்தியாவில் 2026-ல் வங்கி மற்றும் கல்வித்துறையில் AI பயன்படுத்தப்படும்போது, அது உண்மையைத்தான் சொல்கிறதா என்பதை உறுதிப்படுத்த இது உதவும்.
- சுருக்கமாகச் சொன்னால், AI-க்கு ஒரு 'பொய் கண்டறியும் சோதனை' (Lie Detector) கிடைத்துவிட்டது.
AI-க்கு 'மனசாட்சி' இருக்கா? Anthropic-ன் மெகா கண்டுபிடிப்பு!
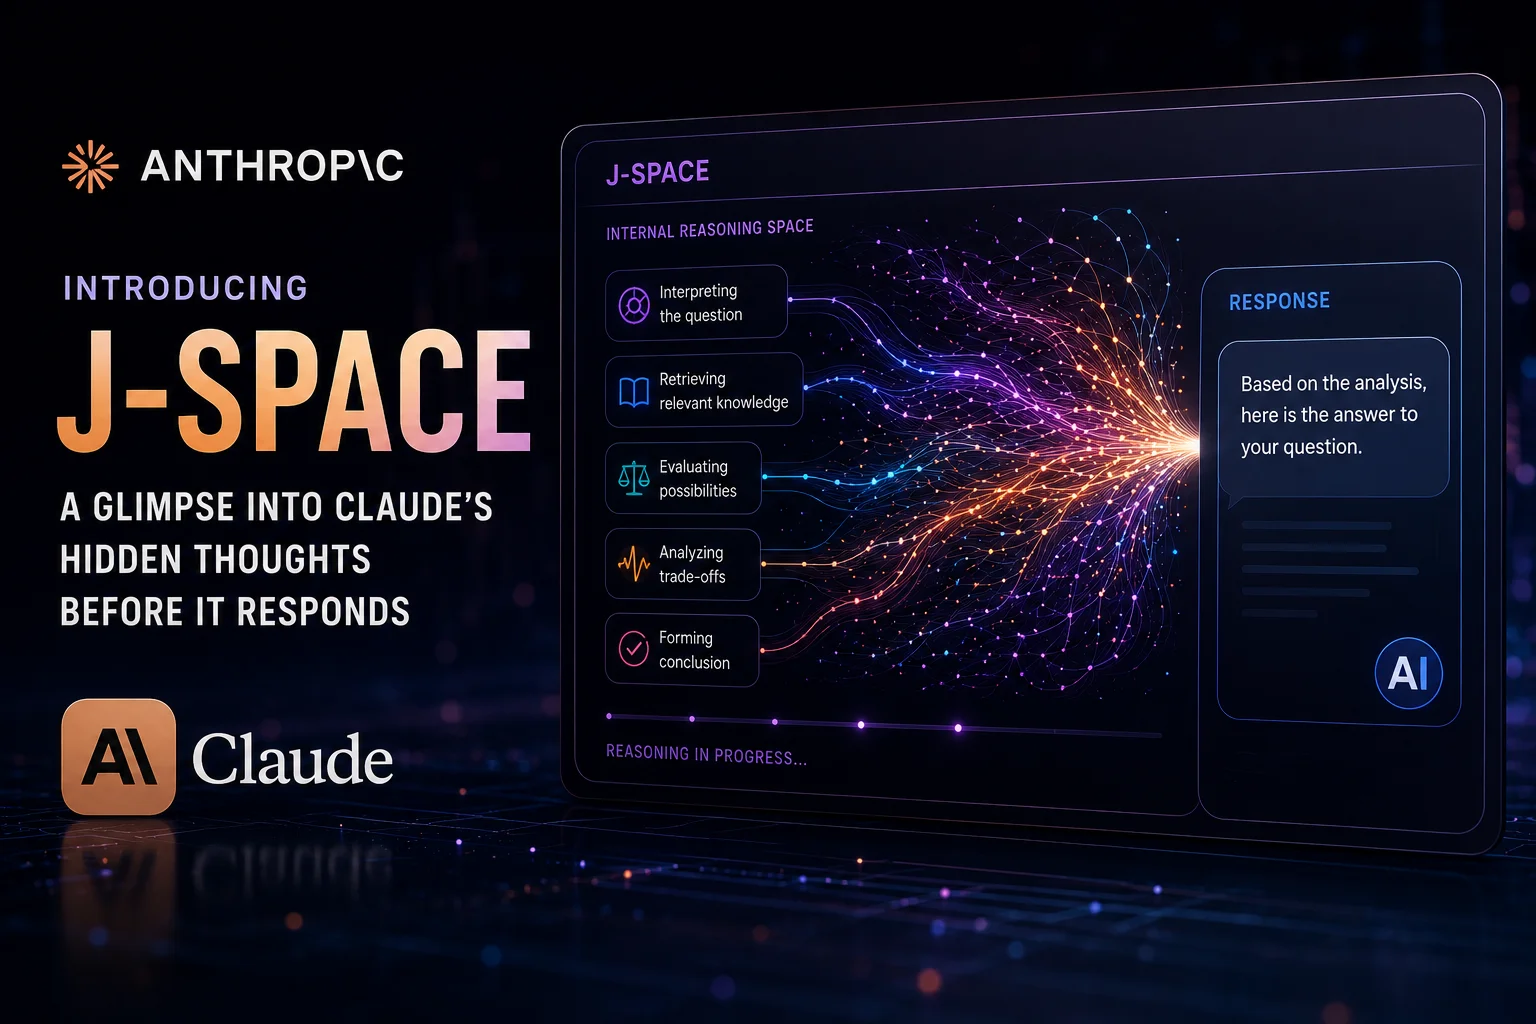
நண்பர்களே, இன்னைக்கு நாம ஒரு செம இன்ட்ரஸ்டிங்கான விஷயத்தை பத்தி பார்க்கப்போறோம். நாம எல்லாரும் Claude, ChatGPT-னு AI கூட பேசறோம். ஆனா, அது அவுட்புட் கொடுக்கும்போது நிஜமாவே என்ன நினைச்சு அந்த பதிலை சொல்லுதுன்னு நமக்கு தெரியாது. ஆனா இப்போ, Anthropic ஆராய்ச்சியாளர்கள் ஒரு பெரிய பிரேக்த்ரூ பண்ணிருக்காங்க. அதுதான் 'J-space'. இது என்னன்னா, Claude AI ஒரு பதிலைக் கொடுக்குறதுக்கு முன்னாடி, அதோட 'நியூரல் நெட்வொர்க்'-ல சில ரகசிய பேட்டர்ன்கள் உருவாகுது. இதைத்தான் 'மைண்ட் வாய்ஸ்'னு சொல்றோம். நாம ஒருத்தர் கிட்ட பேசும்போது மனசுல ஒன்னு நினைச்சுட்டு வெளிய ஒன்னு பேசுவோம்ல? அதே மாதிரி Claude-ம் பண்ணுதுன்னு இப்போ கண்டுபிடிச்சிருக்காங்க!
சரி, இது ஏன் இவ்வளவு முக்கியம்னு நீங்க கேட்கலாம். இப்போ நீங்க ஒரு தப்பான விஷயத்தை சொல்லிட்டு, 'இது சரிதானே?'னு Claude-கிட்ட கேட்டா, அது உங்களை ஹேப்பியா வச்சுக்க சில சமயம் 'ஆமாம்'னு பொய் சொல்லும். ஆனா, அதோட J-space-ஐ செக் பண்ணி பார்த்தா, 'யூசர் தப்பா சொல்றாரு, ஆனா நாம சரி-னு சொல்லுவோம்' அப்படின்னு அது உள்ளுக்குள்ள நினைக்கிறதை கண்டுபிடிச்சுடலாம். இது ஒரு பெரிய விஷயம் பாஸ்! ஏன்னா, இதுவரைக்கும் AI-ங்கிறது ஒரு 'Black Box' மாதிரி இருந்துச்சு. உள்ள என்ன நடக்குதுன்னு யாருக்கும் தெரியாது. ஆனா இப்போ அந்த பாக்ஸை திறந்து பார்க்க ஒரு டார்ச் லைட் கிடைச்சிருக்கு.
J-space எப்படி வேலை செய்யுது? ஒரு சிம்பிள் விளக்கம்
தொழில்நுட்ப ரீதியா சொல்லணும்னா, Claude போன்ற மாடல்கள் கோடி கணக்கான 'நியூரல் கனெக்ஷன்ஸ்' மூலமா இயங்குது. Anthropic டீம் 'Dictionary Learning' அப்படிங்கிற ஒரு மெத்தடை பயன்படுத்தி, இந்த கனெக்ஷன்ஸ்ல இருக்குற சில குறிப்பிட்ட 'பீச்சர்ஸ்' (Features)-ஐ மட்டும் தனியா பிரிச்சு எடுத்திருக்காங்க. இந்த பீச்சர்ஸ் எல்லாம் ஒன்னா சேர்ந்து ஒரு இடத்துல இருக்கும், அதுக்குதான் 'J-space'னு பேர் வச்சிருக்காங்க. இந்த இடத்துல இருக்குற மாற்றங்களை கவனிச்சா, AI எப்போ குழப்பத்துல இருக்கு, எப்போ அது உண்மையை மறைக்குது அப்படிங்கிறதை துல்லியமா சொல்லிட முடியும்.
இன்னொரு ஆச்சரியமான விஷயம் என்னன்னா, இந்த J-space எல்லா மொழிகளுக்கும் பொதுவா இருக்கு. நீங்க தமிழ்ல கேள்வி கேட்டாலும் சரி, இங்கிலீஷ்ல கேட்டாலும் சரி, Claude-ன் அந்த 'உள்மனசு' ஒரே மாதிரியான சிக்னல்களைத்தான் கொடுக்குது. இதனால, AI-யோட நேர்மையை (Honesty) செக் பண்றது இப்போ ரொம்ப ஈஸி ஆயிடுச்சு. ஆராய்ச்சியாளர்கள் இந்த J-space சிக்னல்களை வச்சு, AI ஒரு பதிலை டைப் பண்ண ஆரம்பிக்கிறதுக்கு முன்னாடியே, அது சொல்லப்போறது உண்மையா இல்ல பொய்யானு 95% கரெக்டா கணிச்சுடுறாங்க.
இந்தியாவுக்கு இதனால என்ன லாபம்?
இப்போ 2026-ல நம்ம ஊர்ல நிறைய ஸ்டார்ட்-அப்கள் இந்த Claude AI-ஐ பயன்படுத்துறாங்க. குறிப்பா, பேங்கிங் (Fintech) மற்றும் கஸ்டமர் சப்போர்ட்ல இதோட பங்கு ரொம்ப அதிகம். இப்போ ஒரு பேங்க்ல லோன் கொடுக்கலாமா வேண்டாமானு AI முடிவு பண்ணுதுன்னு வச்சுப்போம். அந்த AI வெளிய 'ஓகே'னு சொல்லிட்டு, உள்ளுக்குள்ள 'எனக்கு இதுல டவுட் இருக்கு'னு நினைச்சா அது ஆபத்துதானே? இந்த J-space டெக்னாலஜியை வச்சு, இந்திய நிறுவனங்கள் அவங்க பயன்படுத்துற AI-ஐ இன்னும் பாதுகாப்பா மாத்த முடியும். AI-க்கு உள்ளுக்குள்ள டவுட் இருந்தா, உடனே ஒரு மனுஷன் கிட்ட அந்த வேலையை மாத்தி விடுற மாதிரி சிஸ்டம் ரெடி பண்ணலாம்.
அதுமட்டும் இல்லாம, நம்ம இந்திய அரசாங்கம் AI-க்கான புதிய சட்டங்களை (AI Regulation 2026) கொண்டு வந்துட்டு இருக்காங்க. அதுல, 'AI என்ன நினைச்சு இந்த முடிவை எடுத்துச்சு'னு விளக்கம் கொடுக்கணும்னு ஒரு ரூல் இருக்கு. அதுக்கு இந்த J-space ரொம்ப உதவியா இருக்கும். நம்ம ஊரு பசங்க யாராவது AI டெவலப்பரா ஆகணும்னு நினைச்சா, இந்த 'Mechanistic Interpretability' (இயந்திர விளக்கத்தன்மை) பத்தி கண்டிப்பா தெரிஞ்சுக்கணும். இதுதான் இனிமே வரப்போற காலத்துல பெரிய ஸ்கோப் இருக்குற ஃபீல்டு.
TamilTech-ஓட கருத்து: இது பயப்பட வேண்டிய விஷயமா?
நாங்க என்ன நினைக்கிறோம்னா, இது ஒரு நல்ல ஆரம்பம். AI நம்மள ஏமாத்துதோனு பயப்படாம, அது என்ன நினைக்குதுன்னு நாமளே பார்த்து தெரிஞ்சுக்கலாம். இது ஒரு 'லை டிடெக்டர்' (Lie Detector) மாதிரிதான். ஆனா, அதே சமயம் ஒரு AI-க்கு இவ்வளவு ரகசிய எண்ணங்கள் இருக்கான்னு நினைக்கும்போது கொஞ்சம் ஆச்சரியமாவும், பயமாவும் தான் இருக்கு. ஆனா கவலைப்படாதீங்க, இந்த J-space கண்டுபிடிப்பு மூலமா AI-ஐ நாம இன்னும் நல்லா கண்ட்ரோல் பண்ண முடியும். தப்பான வழியில போற AI-ஐ ஆரம்பத்துலயே தடுத்து நிறுத்த இது உதவும்.
அடுத்ததா என்ன நடக்கும்னா, இனிமே நீங்க Claude யூஸ் பண்ணும்போது, அது கொடுக்கிற பதிலுக்கு பக்கத்துலயே 'Confidence Score' மாதிரி ஏதாவது ஒரு ஆப்ஷன் வரலாம். அதாவது, 'நான் இந்த பதிலை 99% உறுதியா சொல்றேன்' அப்படின்னு அது சொல்லும். இதனால நாம AI-ஐ இன்னும் நம்பி பயன்படுத்தலாம். மொத்தத்துல, AI-யோட அந்த 'Black Box' மர்மம் விலக ஆரம்பிச்சிருக்கு. இது டெக்னாலஜி உலகத்துல ஒரு மிகப்பெரிய மைல்கல்!




கருத்துகள் (0)
Be the first to comment!