

முக்கிய விஷயங்கள்
- Image + Text இரண்டையும் படிக்கும் AI Model-களுக்கு உள்ளே ஒரு 'Hidden Space' இருக்குதுனு S-Space பேப்பர் சொல்லுது.
- இந்த Space, Object-களோட Position-ஐ Horizontal, Vertical, Distance அப்படி மூணு Axis-ல Track பண்ணுதாம்.
- இதை யாரும் Specific-ஆ Train பண்ணலை. இது தானா Model-க்கு உள்ள Form ஆகிடுச்சு.
- Spatial Question கேட்காம இருந்தாலும் இந்த Map Readable-ஆ இருக்குது.
- Hugging Face-ல 265 Upvotes, GitHub-ல 247 Stars - AI Research Community நல்லா கவனிச்சிருக்காங்க.
- இது இன்னும் Lab Research மட்டும்தான். நம்ம Phone App-ல இன்னைக்கே வராது.
என்ன நடந்தது?
நீங்க ChatGPT-ல ஒரு Photo Upload பண்ணி, "Cup Laptop-க்கு Left Side-ல இருக்கா?"னு கேட்டீங்கன்னா, பெரும்பாலும் சரியா சொல்லும். இப்போ இது Normal-ஆ தெரியும்தான். ஆனா இதுக்கு பின்னாடி ஒரு பெரிய கேள்வி இருந்துச்சு. Model உண்மையிலயே Object Position-ஐ Internal-ஆ Track பண்ணுதா? இல்ல வெறும் Millions of Images Pattern-Match பண்ணி Guess பண்றதா?
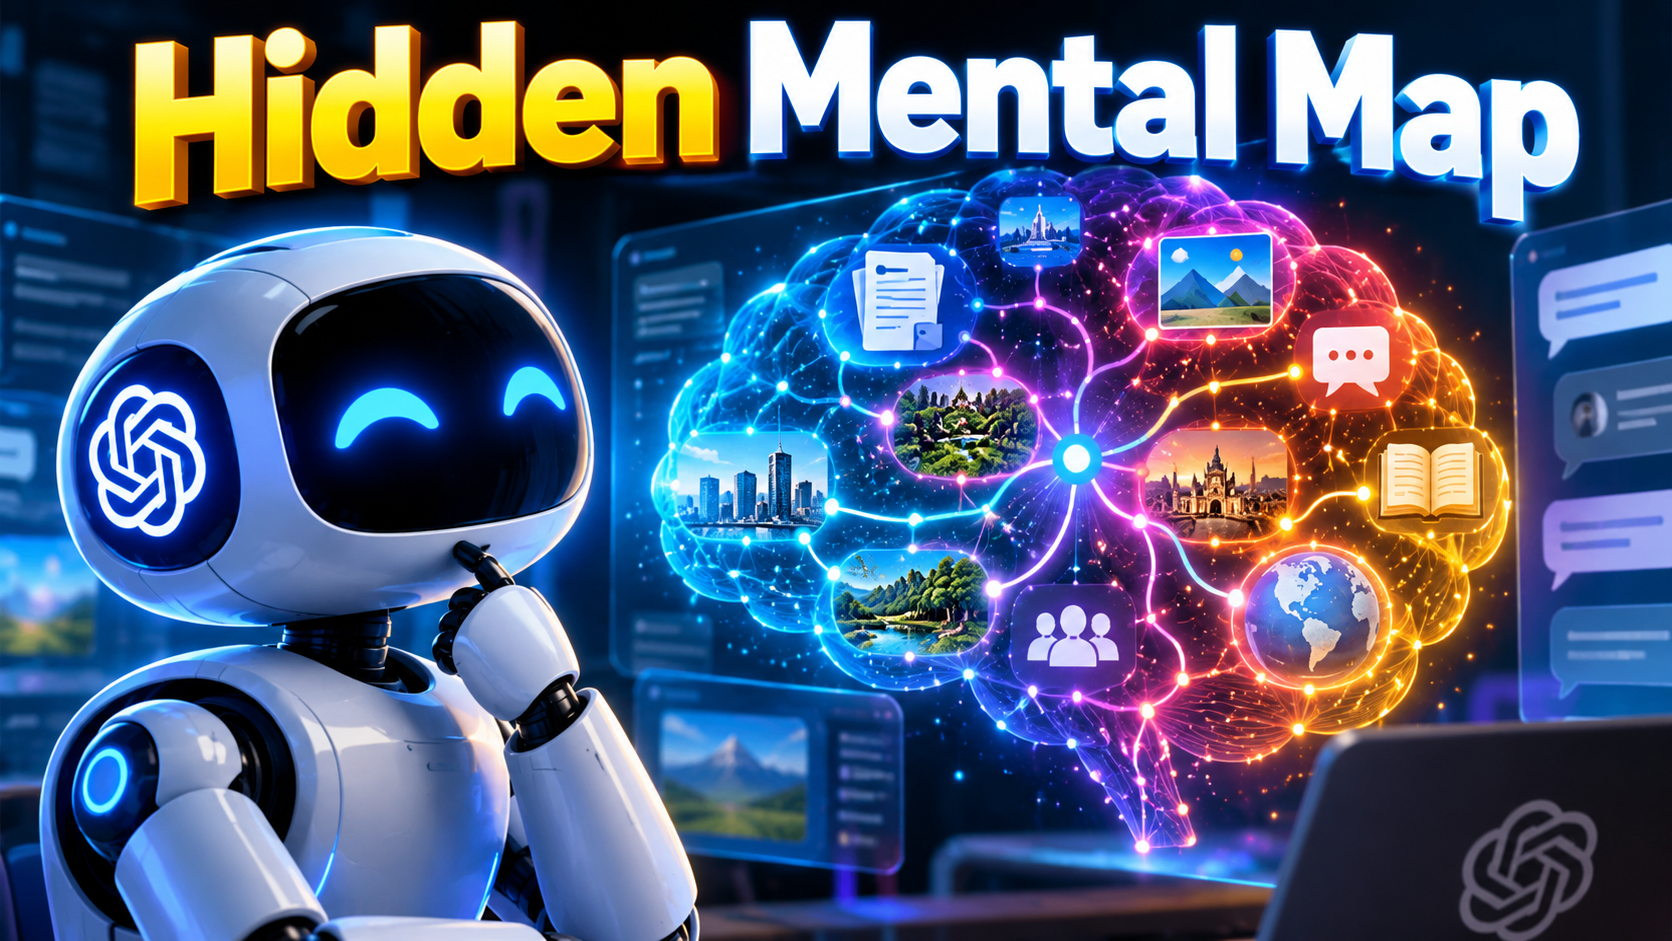
MirroS என்ற Research Team இந்த கேள்விக்கு பதில் தேடி ஒரு Paper வெளியிட்டாங்க - S-Space: Exploring Spatial Workspace in Multimodal Language Models. இதில் ஒரு Specific Internal Layer கண்டுபிடிச்சிருக்காங்க, அதில Object Positions Coordinates-ஆ Store ஆகுதாம். Words இல்ல, Guess இல்ல, நேரடியா Coordinates - ஒரு Graph-ல Point போடுற மாதிரி.
இந்த Paper, இந்த மாசம் AI Community-ல நல்ல Talk-ஆ இருக்குது. Hugging Face Papers-ல 265 Upvotes, Code GitHub-ல Open-ஆ இருக்கு, அதுக்கு 247 Stars. ஒரு Research Paper-க்கு இது பெரிய Number.
இது எப்படி வேலை செய்யும்? (அதாவது + உதாரணம்)
எளிமையா சொன்னா, உங்க Brain-ல ஒரு Invisible Whiteboard இருக்குனு Imagine பண்ணுங்க. யாரும் உங்களுக்கு அதை வரையனும்னு சொல்லலை, ஆனா ஒரு Room-க்கு Enter ஆன உடனே, Chair இங்க, Door அங்க, ஆள் Table-க்கு பின்னாடி நிக்குறாரு - இது எல்லாம் Automatic-ஆ Mind-ல Mark ஆகும்.
அதேமாதிரி தான் S-Space. Model ஒரு Image-ஐ பார்க்கும் போது, ஒவ்வொரு Object-க்கும் மூணு Axis-ல ஒரு Position Mark பண்ணுதாம் - Horizontal (Left-Right), Vertical (Up-Down), Distance (Near-Far).
Researchers இதை எப்படி கண்டுபிடிச்சாங்கனா, Model Spatial Question-க்கு பதில் சொல்லும் போது, அதன் Internal Activations எப்படி Change ஆகுதுனு Study பண்ணாங்க. ஆனா Abstract-ல சொல்லுற ஆச்சரியமான Point என்னனா - நீங்க "Cup Color என்ன?"னு Non-Spatial Question கேட்டாலும், இந்த Map அப்படியே Readable-ஆ இருக்குது.
அதாவது, Model இந்த Map-ஐ உங்க Spatial Question-க்காக Specially உருவாக்கல. இது Default-ஆவே அதுக்குள்ள இருக்குது. Image பார்க்கும் போது Perception இதை Fill பண்றது. நாம Viewpoint Change பண்ணும் Question கேட்டா, Internal Reasoning இந்த Map-ஐ Transform பண்ணி, புதுசா Calculate பண்றதுனு Paper சொல்லுது.
இன்னும் இண்டரெஸ்டிங் என்னனா, இந்த Map-ஐ Researchers Causal Intervention மூலமா Edit பண்ணி பார்த்தாங்க. அப்போ Spatial Answer மாறுது, ஆனா மத்த Answers அப்படியே இருக்குது. அதாவது, Model Verbal Response தர Specific-ஆ இந்த S-Space-ஐ தேர்ஞ்சு Access பண்றதுனு இது Prove பண்ணுது.
இந்தியாவுல / நம்ம Phone-ல என்ன மாறும்?
இப்போதைக்கு Straight-ஆ சொல்லணும்னா, நம்ம Phone-ல இருக்க Gemini, ChatGPT App-ல இந்த Update வராது. இது Lab Research, Product Feature இல்ல.
ஆனா Indian Developers, Startups-க்கு இது ஏன் Important-ன்னு பாக்கலாம். Bengaluru, Chennai, Hyderabad-ல Computer Vision, Robotics, AR/VR மேல Work பண்ணுற Startups ஏராளம் இருக்காங்க. இவங்களுக்கு இந்த Research ஒரு Clue - AI Model ஏன் சில நேரம் Left-Right Mix Up பண்றது, 'Behind' vs 'In Front' Confuse ஆகுறதுன்னு Explain பண்ணுது.
உதாரணமா, ஒரு E-commerce App-ல Visual Search Feature Build பண்ணுறீங்கன்னா - "இந்த Product-ஐ போல, ஆனா Left Side-ல வேற Color இருக்கற மாடல்" - இந்த Type Spatial Understanding Important ஆகும். இந்த Paper சொல்லுற Bottleneck-ஐ தெரிஞ்சுக்கிறது, உங்க Model Fail ஆகுற Spots-ஐ முன்னாடியே Predict பண்ண உதவும்.
Indian Robotics, Drone, Self-Driving Research Lab-களும் (IIT Madras, IIIT Hyderabad மாதிரி Institutes) இந்த Type Internal Mechanism Research-ஐ Follow பண்றாங்க. ஏன்னா Spatial Reasoning Fail ஆனா, Robot ஒரு Wall-ல Crash ஆகலாம், Drone Wrong Direction போகலாம். இந்த Paper அந்த Risk-ஐ Reduce பண்ண ஒரு Diagnostic Tool தர்றதா சொல்லுது.
Students-க்கு, Interpretability Research (அதாவது AI Model Internal-ஆ எப்படி Think பண்றதுனு ஆராய்ச்சி) இப்போ Hot Topic. இந்த Field-ல Career Build பண்ணணும்னா, இந்த Paper போன்ற Work-ஐ Follow பண்றது நல்லது.
நீங்க இப்போ என்ன பண்ணுங்க?
பதறாதீங்க, இது இன்னும் Product-ஆ மாறல. உடனே உங்க App-ல இந்த Feature வந்துருச்சுனு யாரும் சொல்ல முடியாது.
GitHub-ல Code Open-ஆ இருக்கு (247 Stars). AI, ML Learn பண்ணுற Developers, Students, இதை Download பண்ணி Experiment பண்ணலாம். Paper Page-ஐ (huggingface.co/papers/2610.13527) ஒரு தடவை பாருங்க, ஆனா Full Technical Depth வேணும்னா Patience Need.
Startups Vision-Based Product Build பண்றாங்கன்னா, இந்த Space-ல வரும் Future Research-ஐ Watch பண்ணுங்க. இதே Team இல்ல வேற Team, இதை Base பண்ணி Model Fine-Tune பண்ணி, Error Rate குறைக்க முடியும்.
மத்தபடி, இது ஒரு நல்ல Reminder - AI Model எவ்வளவு Smart-ஆ Answer சொல்லுனாலும், அதுக்கு பின்னாடி என்ன நடக்குதுனு நாம 100% தெரிஞ்சுக்கல. இந்த Type Research தான் அந்த Black Box-ஐ கொஞ்சம் கொஞ்சமா Open பண்ணுது.
இதில் நாம Common-ஆ பண்ற Mistakes
பல பேரு இந்த News படிச்சதும், "இப்போவே நம்ம Phone Camera, Google Lens எல்லாம் இப்படி Smart-ஆ Spatial-ஆ யோசிக்கும்"னு நினைக்கிறாங்க. ஆனா இது தப்பு எண்ணம். இந்த S-Space Discovery வெறும் Lab Experiment, Research Paper மட்டும்தான். இது எந்த Commercial Product-லயும் இன்னும் Integrate ஆகல. Chennai-ல இருக்குற ஒரு Developer, இதை படிச்சு உடனே தன் App-ல "Spatial AI Feature" வந்துடுச்சுனு Marketing பண்ணினா, அது Customer-ஐ Mislead பண்ணுறதுக்கு சமம்.
இன்னொரு Common Mistake, AI Model Spatial Reasoning பண்றதுனா, அது Human Eye மாறி "பார்க்குது"னு நினைக்கிறது. உண்மையிலே Model Pixel Data-ஐ Number-ஆ Convert பண்ணி, அதை Pattern-ஆ Process பண்றதுதான். Madurai-ல ஒரு Agri-Tech Startup, Drone Camera Feed Analyze பண்ண இதே Confusion-ல Mistake பண்ணலாம் - "Model Accurate-ஆ Distance Measure பண்ணும்"னு 100% நம்பி, Crop Health Decision எடுக்கிறது Risky. ஏன்னா இந்த Paper-ஆவே சொல்றது, S-Space சில இடங்கள்ல Break Down ஆகுதுனு, அதாவது Left-Right Confuse ஆகும் Spots இருக்குனு.
மூணாவது Mistake, GitHub Code-க்கு 247 Stars இருக்குனு பார்த்து, இதை நேரா Production App-ல Use பண்ணலாம்னு நினைக்கிறது. Research Code Reproducibility-க்காக Release ஆகுதுதான், அது Production-Ready Software இல்ல. Coimbatore, Trichy மாதிரி Cities-ல இருக்குற சின்ன Startups, இதை Direct-ஆ Integrate பண்ண Try பண்ணா, Stability, Scalability Issues வரலாம். முதல்ல இதை Research Environment-ல நல்லா Test பண்ணி, அப்புறமா Production Thinking பண்றது நல்லது.
முன்னாடி Research-உடன் Comparison - இனி என்ன எதிர்பார்க்கலாம்?
இதுக்கு முன்னாடியும் AI Interpretability Research நடந்திருக்கு - Example-ஆ, Language Model-ல Specific Concept Store ஆகுற Direction கண்டுபிடிச்ச Paper்கள், இல்ல Vision Model-ல Object Recognition Layer-ஐ Map பண்ண Paper எல்லாம் வந்திருக்கு. ஆனா அந்த Research-ல பெரும்பாலும் ஒரு Single Property (Example: Color, Object Class) மட்டும் Track பண்றதுனு இருந்தது. S-Space Paper Special ஆகுறது என்னனா, இது Three-Dimensional Spatial Coordinate System-ஐ ஒரே Subspace-ல கண்டுபிடிச்சிருக்கு, அதுவும் Explicit-ஆ Train பண்ணாம, தானா Form ஆன Structure-ஆ.
இனி Future-ல என்ன நடக்கும்னு பார்த்தா, இந்த Type Foundational Research Normally Follow-Up Paper-களுக்கு Lead பண்ணும். அதாவது, இந்த S-Space-ஐ Base பண்ணி, இன்னொரு Team இதை Fine-Tune பண்ணி, Model-ஐ இன்னும் Accurate-ஆ Spatial Question-க்கு பதில் சொல்ல வைக்கலாம். அல்லது, Robotics Company ஒன்னு, இந்த Subspace-ஐ Directly Access பண்ணி, Robot Navigation-ல Error Rate குறைக்கிற மாதிரி Engineering Trick பண்ணலாம். இது எல்லாம் நடக்க இன்னும் Time Take ஆகலாம், ஏன்னா Lab Research-ல இருந்து Product Feature வர நல்ல Testing, Validation Process Need.
Chennai, Bengaluru IT Hub-ல Work பண்ணுற AI Engineers-க்கு இது ஒரு Signal - Multimodal Model Internal Structure Research இப்போ Trending Topic. இதுக்கு முன்னாடி Text-Only LLM Interpretability Research நிறைய வந்துச்சு, இப்போ Vision+Text Model-க்கும் இதே Depth Research Start ஆகுது. எதிர்காலத்துல, நம்ம Phone-ல இருக்குற Camera App, Navigation App Spatial Question-ஐ இன்னும் Confident-ஆ, Accurate-ஆ Answer பண்ண இந்த Type Foundational Research உதவும் - ஆனா அது இன்னிக்கோ நாளைக்கோ வராது, Patience Need.

கருத்துகள் (0)
Be the first to comment!