

முக்கிய விஷயங்கள்
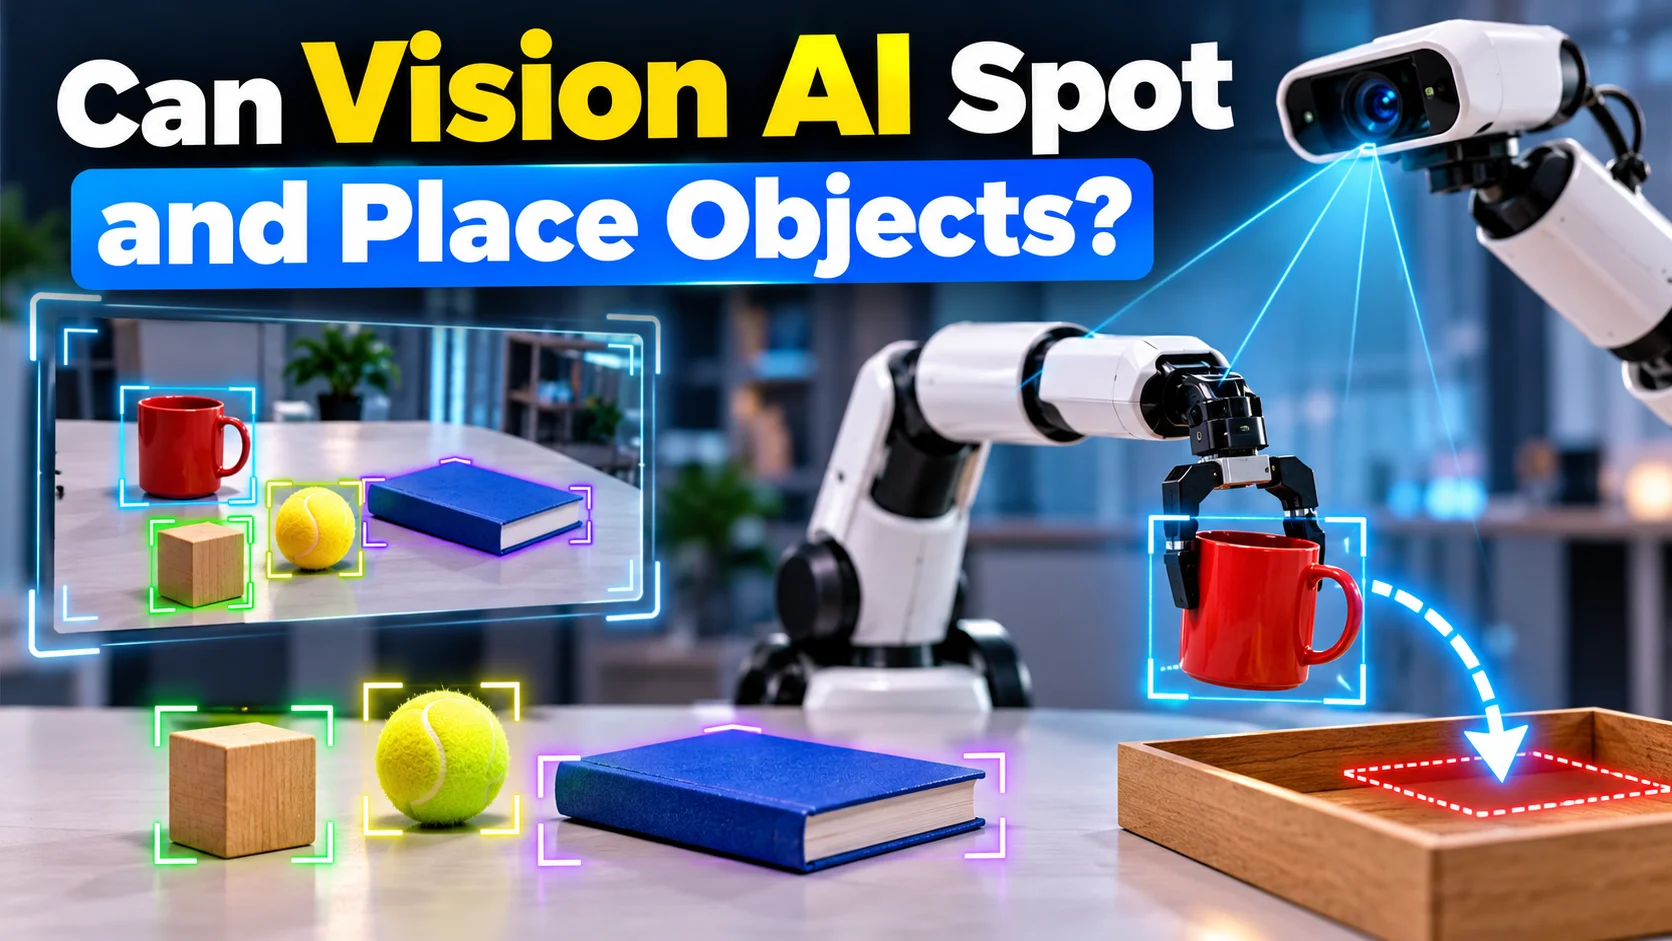
- டீக்கடையில் கை நழுவும் காபி டம்ளரை சட்டென பிடிப்பது போன்ற உடனடி மூளைச் செயல்பாட்டை (System 1) AI விஷன் மாடல்களுக்கு MJev-Spatial கொண்டு வருகிறது.
- பொதுவாக Vision-Language மாடல்கள் coordinates-ஐ பெரிய வரிகளாக autoregressive முறையில் டைப் செய்து லேட்டன்சியை உருவாக்கும்; ஆனால் இது எந்தப் புதிய டோக்கனையும் உருவாக்காமல் நேரடி classification மூலம் கணிக்கிறது.
- Mind Lab குழுவினர் Qwen3.5-4B மாடலின் அடிப்படையிலும், 12.3 மில்லியன் spatial தரவுகளிலும் இதை உருவாக்கி, training throughput-ஐ 30.8% அதிகரித்துள்ளனர்.
- இந்தியாவில் Blinkit, Zepto போன்ற dark store ரோபோட்கள், ட்ரோன்கள் மற்றும் பார்வைக்கு உதவும் assistive tech உருவாக்கும் பொறியாளர்களுக்கு இது மிகக் குறைந்த கணினிச் செலவில் உதவும்.
MJev-Spatial அப்படின்னா என்ன?
டீக்கடையில் உட்கார்ந்து சூடான ஃபில்டர் காபி குடிக்கும்போது, கை நழுவி டம்ளர் மேசையிலிருந்து கீழே விழப் போகுதுன்னு வைப்போம். உங்க மூளை உடனே என்ன பண்ணும்? 'டம்ளர் இப்போது 30 டிகிரி சாய்வில் இருக்கிறது, தரையிலிருந்து 2 அடி உயரத்தில் விழுகிறது' என்று கட்டுரையா எழுதும்? இல்லவே இல்லை. கண்ணிமைக்கும் நேரத்தில் கை தானாக நீண்டு டம்ளரை பிடிக்கும். இதைத்தான் உளவியலில் உடனடி எதிர்வினை அல்லது System 1 சிந்தனை என்பார்கள்.
ஆனால், இப்போது நாம் பயன்படுத்தும் மல்டிமாடல் Vision-Language மாடல்கள் (VLM) இதற்கு நேர்மாறாக செயல்படுகின்றன. ஒரு கேமரா காட்சியை கொடுத்து, 'அந்த பார்சல் எந்த ரேக்கில் இருக்கு?' என்று கேட்டால், அந்த மாடல் வார்த்தை வார்த்தையாக 'The parcel is located at...' என்று டைப் அடிக்க ஆரம்பிக்கும். கடைசியில் இரண்டு coordinates கொடுப்பதற்குள் கணிசமான நேரம் வீணாகிவிடும். ரோபோட்கள் வேகமாக இயங்க வேண்டிய இடத்தில் இந்த தாமதம் பெரிய ஆபத்து.
இதற்கு தீர்வாக Mind Lab ஆய்வாளர்கள் உருவாக்கியுள்ள புதிய மாடல்தான் MJev-Spatial. அதாவது, காட்சி சார்ந்த இடவெளி புரிதலை (spatial intelligence) ஒரு கட்டுரை எழுதும் வேலையாகப் பார்க்காமல், மின்னல் வேகத்தில் முடிவெடுக்கும் வகைப்பாடு (classification) பிரச்சனையாக இந்த மாடல் மாற்றுகிறது. இந்த ஆராய்ச்சியின் விவரங்கள் https://huggingface.co/papers/2610.22276 என்கிற ஆய்வுப் பக்கத்தில் பகிரப்பட்டுள்ளன.
Native Attention Matching எப்படி வேலை செய்யுது?
வழக்கமான AI முறையை ஒரு மாணவன் தேர்வுத் தாளில் விரிவான விடை எழுதுவதற்கு ஒப்பிடலாம். விடை எழுத அதிக நேரம் எடுக்கும், அதைத் திருத்துவதும் கடினம். MJev-Spatial மாடலோ இதை ஒரு OMR ஷீட் போல மாற்றுகிறது. மாணவர் சரியான ஆப்ஷனை மட்டும் டிக் அடிப்பது போல, மாடல் உடனடியாக முடிவை எடுத்துவிடுகிறது.
இந்த ஆய்வில் இடவெளி சார்ந்த கேள்விகளை மூன்று வகையாகப் பிரிக்கிறார்கள்: ஒன்று, இரண்டு பொருட்களுக்கு நடுவில் உள்ள தொடர்பு (உதாரணமாக, லேப்டாப்பிற்கு இடதுபுறம் மொபைல் இருக்கிறதா?). இரண்டாவது, ஒரு பொருள் எவ்வளவு தூரத்தில் இருக்கிறது என்கிற எண் மதிப்பு. மூன்றாவது, திரையில் எந்தப் புள்ளியை ரோபோ கை தொட வேண்டும் என்கிற 2D கோஆர்டினேட்.
இங்கேதான் ஆராய்ச்சியாளர்கள் ஒரு அருமையான டெக்னிக்கைப் பயன்படுத்துகிறார்கள். மாடலில் புதிய தலைகளையோ (extra parameters) கூடுதல் லேயர்களையோ சேர்க்கவில்லை. ஏற்கனவே உள்ள pretrained backbone நெட்வொர்க்கில் இருக்கும் Query மற்றும் Key projections-ஐ மட்டுமே பயன்படுத்தி இந்த ஆப்ஷன்களை ஒப்பிடுகிறார்கள். தூரங்கள் மற்றும் புள்ளிகளைத் தேர்வு செய்ய coarse-to-fine classification முறையைப் பயன்படுத்துகிறார்கள். அதாவது, முதலில் ஒரு பரந்த பகுதியைத் தேர்ந்தெடுத்து, பின் அதே forward pass-ல் துல்லியமான புள்ளியைக் குறித்துவிடுகிறது.
இந்த Model-னால Indian Developers-க்கு என்ன லாபம்?
இந்தியாவில் இப்போதைக்கு குவிக்-காமர்ஸ் துறை அசுர வேகத்தில் வளர்ந்து வருகிறது. Zepto, Blinkit, Instamart போன்ற நிறுவனங்களின் dark store கிடங்குகளில் தானியங்கி ரோபோட்களைப் பயன்படுத்தும் முயற்சிகள் நடக்கின்றன. அங்கே ஒரு ரோபோ பார்சலை எடுக்க வேண்டும் என்றால், மில்லி விநாடிகளில் முடிவு எடுக்க வேண்டும். டெக்ஸ்ட் ஜெனரேட் செய்யும் மாடல்களைப் போட்டால் சர்வர் செலவு எகிறிவிடும், வேகமும் கிடைக்காது.
MJev-Spatial போன்ற உத்திகள் மூலம், Qwen3.5-4B போன்ற ஒப்பீட்டளவில் சிறிய ஓப்பன் மாடலிலேயே அதிவேக spatial முடிவுகளை எடுக்க முடிகிறது. இந்த ஆய்வில் 12.3 மில்லியன் spatial ஜோடிகளைக் கொண்டு பயிற்சி செய்திருக்கிறார்கள். மேலும் length-aware batching மற்றும் cross-GPU load balancing முறையைப் பயன்படுத்தி, பயிற்சி வேகத்தை 30.8% உயர்த்திக் காட்டியுள்ளனர்.
சென்னையிலோ பெங்களூருவிலோ ட்ரோன் தொழில்நுட்பம் செய்யும் ஸ்டார்ட்அப்கள் அல்லது விபத்துகளைத் தவிர்க்கும் கேமரா சிஸ்டம் உருவாக்கும் இன்ஜினியர்களுக்கு இது ஒரு வரப்பிரசாதம். பெரிய கிளவுட் GPU-க்கள் இல்லாமல், சாதனத்தின் உள்ளேயே (edge device) குறைந்த மின் நுகர்வில் பார்வை முடிவுகளை எடுக்க இந்த முறை அடித்தளம் அமைக்கிறது.
Spatial AI பண்ணும்போது developers என்ன mistake பண்றாங்க?
பல இந்திய AI டெவலப்பர்கள் ஒரு பொருளின் இருப்பிடத்தைக் கண்டுபிடிக்க நினைத்ததும், உடனடியாக வழக்கமான multimodal LLM-ஐ எடுத்து முழு விடையையும் டெக்ஸ்ட்டாக வரவழைப்பார்கள். பிறகு அந்தப் பதிலில் இருந்து நமக்குத் தேவையான x, y எண்களைப் பிரிக்க பெரிய Regex ஸ்கிரிப்ட்டுகளை எழுதுவார்கள். இது மிகப்பெரிய தவறு.
காரணம், autoregressive முறையில் ஒவ்வொரு டோக்கனாக AI உருவாக்கும்போது, தேவையில்லாத வார்த்தைகளுக்கும் சேர்த்து GPU மெமரி காலியாகும். அதுமட்டுமல்லாமல், எப்போதாவது ஒரு கமாவோ புள்ளியோ மாறினால் Regex செயலிழந்து ஒட்டுமொத்த ஆட்டோமேஷனும் நின்றுவிடும். சிறிய தவறான coordinate ஒரு ரோபோ கையை தவறான இடத்தில் மோத வைத்துவிடும்.
இன்னொரு தவறு, இடவெளிப் புரிதலுக்கு தனியாக பெரிய கிளாசிஃபிகேஷன் லேயர்களைச் சேர்த்து மாடலின் எடையை கூட்டுவது. MJev-Spatial காட்டியுள்ள வழி என்னவென்றால், ஏற்கனவே உள்ள மாடலின் attention projections-ஐ வைத்தே பூஜ்ஜிய கூடுதல் பாராமீட்டர்களில் இதைச் சாதிக்க முடியும் என்பதுதான். இதை டெவலப்பர்கள் புரிந்துகொள்ள வேண்டும்.
நீங்க இப்போ என்ன பண்ணணும்?
இந்த தொழில்நுட்பம் இன்னும் தொடக்க நிலை ஆய்வுதான் (early research) என்பதை நினைவில் வையுங்கள். இது உடனடியாக உங்கள் போன் ஆப்பிலோ அல்லது நேரடி வணிக தயாரிப்புகளிலோ வந்துவிடவில்லை. ஆனால் இதன் குறியீடுகள் GitHub தளத்தில் பகிரப்பட்டுள்ளன.
நீங்கள் ரோபோடிக்ஸ், கம்ப்யூட்டர் விஷன் அல்லது ஆட்டோமேஷன் சார்ந்த பணிகளில் இருக்கும் டெவலப்பராக இருந்தால், இந்த ஆய்வுக்கட்டுரையின் அணுகுமுறையை உற்று கவனியுங்கள். டெக்ஸ்ட் ஜெனரேஷனை மட்டுமே நம்பியிராமல், forward pass வகைப்பாடு மூலம் எப்படி விடையைப் பெறலாம் என்பதை உங்கள் சொந்த ப்ராஜெக்ட்டுகளில் பரிசோதித்துப் பாருங்கள்.
குறிப்பாக சிறிய 4B அல்லது 7B மாடல்களை வைத்து குறைந்த செலவில் எட்ஜ்-ஏஐ (Edge AI) உருவாக்க நினைக்கும் மாணவர்களுக்கும் ஸ்டார்ட்அப்களுக்கும் இந்த architectural மாற்றம் புதிய சிந்தனையைத் தரும். அடுத்த தலைமுறை பார்வை மாடல்கள் பேசிக்கொண்டே இருக்காமல், செயலில் வேகம் காட்டும் என்பதை இந்த ஆய்வு தெளிவாக உணர்த்துகிறது.
நம்ம ஊர் சூழலில் இது எங்கெல்லாம் பயன்படும்?
உதாரணமாக, சென்னை அண்ணா சாலையில் அல்லது பெங்களூரு சில்க் போர்டு சிக்னலில் ஒரு ஸ்மார்ட் டிராபிக் கேமரா பொருத்தப்பட்டிருக்கிறது என்று வைத்துக்கொள்வோம். அங்கே வேகமாக வரும் ஆட்டோ அல்லது பைக் பாதசாரிகள் மீது மோதுவதைத் தவிர்க்க உடனடியாக அலர்ட் செய்ய வேண்டும். வழக்கமான பெரிய VLM மாடல்கள் என்றால், கேமரா ஃபிரேமை வாங்கி 'The auto is approaching the pedestrian at coordinate x, y' என்று டோக்கன் டோக்கனாக டெக்ஸ்ட் எழுதி முடிவெடுப்பதற்குள் விபத்து நடந்துவிடும். ஆனால் MJev-Spatial போன்ற ஒரே forward pass மாடல்கள், எந்த டெக்ஸ்ட்டையும் டைப் செய்யாமல் ஆட்டோ எந்தப் புள்ளியில் இருக்கிறது, எவ்வளவு தூரத்தில் வருகிறது என்பதை மில்லி விநாடிகளில் கிளாசிஃபை செய்து உடனே சிக்னலை மாற்றிவிட முடியும்.
அதேபோல, இந்தியாவில் பார்வை குறைபாடு உள்ளவர்களுக்கான assistive navigation கண்ணாடிகள் அல்லது மொபைல் செயலிகளை உருவாக்கும் ஸ்டார்ட்அப்களுக்கும் இது மிகப்பெரிய மாற்றத்தை ஏற்படுத்தும். நம் ஊர் தெருக்களில் திடீரென வரும் மாடுகள், திறந்திருக்கும் பாதாள சாக்கடை மூடிகள் அல்லது நடைபாதைக் கடைகளை ஒரு நபர் கடக்கும்போது, போனில் இருக்கும் AI உடனடியாக 'எங்கே ஒதுங்க வேண்டும்' என்று இடப்பக்கமா அல்லது வலப்பக்கமா என கணப்பொழுதில் சொல்ல வேண்டும். விலையுயர்ந்த 5G கிளவுட் சர்வரை நம்பியிருக்காமல், சாதாரண பட்ஜெட் போனின் சிப்பிலேயே Qwen3.5-4B போன்ற சிறிய மாடலை வைத்து இந்த வகைப்பாட்டை மிகக் குறைந்த லேட்டன்சியில் செய்து முடிக்க இந்த உத்தி வழிகாட்டுகிறது.
அடுத்து AI உலகில் என்ன மாற்றத்தை எதிர்பார்க்கலாம்?
இப்போது AI துறையில் பலரும் சிஸ்டம் 2 (System 2) எனப்படும் நீண்ட யோசனை மாடல்களைப் பற்றியே அதிகம் பேசுகிறார்கள்; அதாவது ஒரு கணிதப் புதிருக்கு ஸ்டெப்-பை-ஸ்டெப்பாக சிந்தித்து விடை சொல்வது. ஆனால் ரோபோட்டிக்ஸ், ட்ரோன் மற்றும் செல்ஃப் டிரைவிங் போன்ற நிஜ உலகக் கருவிகளுக்கு தேவைப்படுவது சிஸ்டம் 1 (System 1) எனப்படும் உள்ளுணர்வு அல்லது உடனடி அனிச்சை செயல்பாடுதான். ஒரு பந்து முகத்தை நோக்கி வரும்போது கண்ணை மூடுவது போல, உடனடி முடிவுகளை எடுக்க டோக்கன் ஜெனரேஷன் தேவையில்லை என்கிற புரிதல் இப்போது ஆய்வாளர்களிடையே வேகமாகப் பரவி வருகிறது. வரும் காலங்களில் பல விஷன் மாடல்கள் இந்த OMR பாணி நேரடி கிளாசிஃபிகேஷன் முறைக்கு மாற அதிக வாய்ப்புள்ளது.
இந்திய இன்ஜினியரிங் மாணவர்களும் AI ஆராய்ச்சியாளர்களும் இனி வெறும் ப்ராம்ப்ட் இன்ஜினியரிங் செய்வதோடு நின்றுவிடாமல், இதுபோன்ற architectural மாற்றங்களைக் கூர்ந்து கவனிக்க வேண்டும். Mind Lab குழுவினர் GitHub-ல் வெளியிட்டுள்ள திறந்த மூலக் குறியீட்டைப் படித்துப் பார்த்து, உங்கள் லோக்கல் பயன்பாடுகளுக்கு ஏற்ப coarse-to-fine classification முறையை எப்படிப் பயிற்சி செய்யலாம் என்பதை நீங்களே பரிசோதிக்கலாம். அதிக விலை கொண்ட GPU கிளவுட் சர்வர்கள் வாங்க முடியாத சிறிய நிறுவனங்களுக்கும் மாணவர்களுக்கும், எந்தக் கூடுதல் பாராமீட்டர்களும் இல்லாமல் இயங்கும் இந்த நேட்டிவ் அட்டென்ஷன் மேட்சிங் உத்தி, எட்ஜ் கருவிகளில் அடுத்த தலைமுறை ரோபோட்டிக்ஸ் மென்பொருளை உருவாக்க மிகச் சிறந்த வழிகாட்டியாக அமையும்.

கருத்துகள் (0)
Be the first to comment!